Python e NodeJS
A etapa de 🔢 Regra Customizada tem três formas independentes de rodar código próprio (Scripts de Sessão, código Inline e Projetos ZIP), mais três recursos nativos que dispensam código: as Variáveis do Fluxo, a iteração de listas e o Timer de Espera. Esta página dá o panorama de quando usar cada uma e como o isolamento de segurança funciona.
- Quando usar código customizado
- As três formas de código
- Ordem de execução dentro da etapa
- Erros, avisos e variáveis do script
- Versões de Node.js e Python
- Como as dependências são processadas
- Padrões de segurança
- Estado entre etapas
- Limite de Tempo do Script
- Variáveis do Fluxo
- Iterações de Listas
- Timer de Espera
Quando usar código customizado
Use etapas de código quando as ações visuais (navegar, preencher, extrair) não forem suficientes:
- Transformações complexas de dados (parsing de XML, cálculos financeiros)
- Acesso a bibliotecas externas (xlsx, pdf-lib, moment.js, pandas, etc.)
- Chamadas a APIs com lógica de retry, paginação ou autenticação customizada
- Geração de arquivos (PDF, planilhas, ZIP)
- Criptografia, hashing, codificação Base64
- Ajustes de baixo nível na sessão do navegador (diálogos, interceptação de rede, timeouts)
As três formas de código
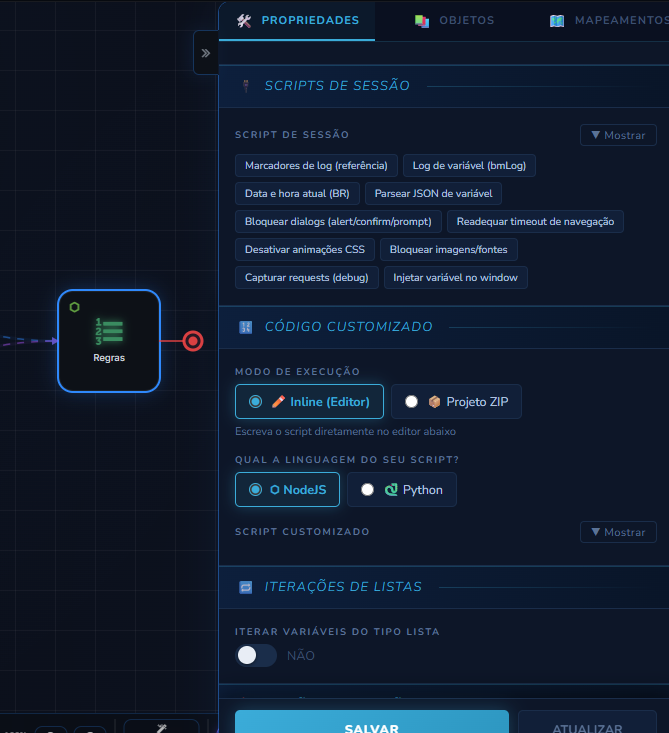
Dentro de uma única etapa de Regra Customizada, os três blocos abaixo são independentes entre si, e dá para usar um, dois ou os três ao mesmo tempo:
| Bloco | O que é | Quando usar |
|---|---|---|
| Scripts de Sessão | Bloco Node.js que roda antes do script principal, com acesso direto à sessão do navegador (Puppeteer). | Ajustes de página/sessão que o código isolado não alcança: bloquear diálogos, interceptar requisições de rede, injetar CSS, ajustar timeouts. |
| Código Inline | Script Node.js ou Python escrito direto no editor da etapa. | Lógica de negócio de porte pequeno ou médio, como parsing, cálculo e chamadas de API, sem precisar de múltiplos arquivos. |
| Projetos e SDK | Projeto ZIP com múltiplos arquivos, enviado via Codebase. | Código extenso, com dependências específicas, versionado em Git, ou reaproveitado entre várias etapas/processos. |
Scripts de Sessão e o script principal (Inline ou Projeto) podem coexistir na mesma etapa: o Script de Sessão roda primeiro, depois o script principal.
Além do código, a etapa tem três blocos que não exigem código nenhum: as Variáveis do Fluxo, que criam e alteram variáveis com valor fixo, variável ou fórmula, as Iterações de Listas, que consomem uma lista item a item, e o Timer de Espera, que faz o processo aguardar alguns segundos antes de seguir. Os três estão descritos no fim desta página.
Ordem de execução dentro da etapa
No painel da etapa, os blocos aparecem na ordem Variáveis do Fluxo, Iterações de Listas, Timer de Espera, Scripts de Sessão e Código Customizado. Essa é a ordem em que você os configura, e não a ordem em que rodam. Na execução, a sequência é:
- Variáveis do Fluxo: as variáveis são criadas ou alteradas antes de qualquer código, então os scripts já as encontram prontas.
- Script de Sessão, se houver.
- Script principal (Inline ou Projeto), se houver.
- Iterações de Listas: a lista avança um item, já com tudo o que os passos anteriores gravaram.
- Timer de Espera: por último, o processo aguarda o tempo configurado e só então segue para a próxima etapa.
Erros, avisos e variáveis do script
Dois recursos acompanham o código escrito direto no editor da etapa (Script Inline e Script de Sessão):
- Erros e avisos no editor: chave a mais, aspa aberta ou indentação errada aparecem em vermelho, com a linha, e a etapa entra no indicador de pendências, o que esconde o botão de publicar até a correção. Variável nunca declarada e JSON quebrado dentro de texto aparecem em amarelo, sem impedir a publicação. Veja Código Inline: Erros de sintaxe.
- Variáveis do script na lista: o que o script grava (
bm.done()no Script Inline,globalData.set()no Script de Sessão) passa a aparecer nos seletores de variáveis das etapas seguintes, sem nada a declarar. Veja Manipulação de Variáveis: Script.
Os dois valem só para código escrito no editor da etapa. O código de um Projeto ZIP não é conferido, e as variáveis que ele grava não entram na lista.
Versões de Node.js e Python
O runtime já vem com as duas linguagens embutidas. Você não precisa instalar nada na máquina para rodar código customizado, e não há passo de configuração de ambiente.
| Linguagem | Versão | Gerenciador de pacotes |
|---|---|---|
| Node.js | 24 (série LTS atual) | npm, para os pacotes declarados no projeto |
| Python | 3.14 | pip, incluído na distribuição embarcada |
Escreva seu código para essas versões. Recursos de linguagem mais novos do que elas não estarão disponíveis, e bibliotecas que exigem uma versão superior não vão instalar.
cgi, cgitb, telnetlib, pipes, imghdr, sndhdr, nntplib, crypt, uu, xdrlib, mailcap, chunk, aifc, audioop, sunau, msilib, nis, ossaudiodev, spwd, imp, asyncore, asynchat, smtpd, distutils e lib2to3. Um script que os importe falha com No module named. Para Telnet e CGI existem substitutos instaláveis, como telnetlib3 e legacy-cgi; nos outros casos, use o equivalente moderno (por exemplo, importlib no lugar de imp, e asyncio no lugar de asyncore).
PATH. Vale conferir isso ao rodar em servidores preparados manualmente.
package.json e requirements.txt). É o que garante que o mesmo script continue produzindo o mesmo resultado.
Como as dependências são processadas
Tanto o Código Inline quanto os Projetos ZIP podem usar bibliotecas externas, e em nenhum dos dois casos existe passo manual de instalação. O que muda entre eles é apenas como você declara o que precisa.
| Forma de código | Como declarar as bibliotecas |
|---|---|
| Código Inline | Basta usar a biblioteca no script. O runtime lê os import do seu código Python e os require() do seu código Node.js, e busca o que não fizer parte da linguagem. |
| Projeto ZIP | Declare no requirements.txt (Python) ou no package.json (Node.js), na raiz do projeto. |
Cada projeto no seu próprio ambiente
As bibliotecas nunca são instaladas dentro do Python ou do Node.js embutidos no runtime. Cada projeto recebe seu próprio espaço de pacotes, isolado dos demais. Isso tem uma consequência prática que vale conhecer: dois agentes podem usar versões diferentes da mesma biblioteca sem conflito, e nada do que um projeto instala afeta os outros nem a máquina.
Quando a instalação acontece
A instalação não roda a cada execução do processo. Ela acontece na primeira execução depois de cada envio do código, e o resultado fica guardado na máquina do runtime. As execuções seguintes reaproveitam o que já está pronto e começam direto no seu código.
No caso dos Projetos ZIP, cada envio conta como um projeto novo para efeito de preparação, mesmo que você tenha mexido apenas no código e não nas dependências. Se você publica ajustes com frequência num projeto de lista longa, é a primeira execução após cada envio que paga a espera.
node_modules no ZIP elimina a espera por completo.
Rodando sem acesso aos repositórios de pacotes
Para instalar, a máquina do runtime precisa alcançar os repositórios públicos de pacotes do npm e do pip. Em redes corporativas fechadas isso costuma estar bloqueado.
No Node.js existe saída: se você incluir a pasta node_modules preenchida dentro do ZIP do projeto, o runtime entende que ele já trouxe suas dependências e não tenta instalar nada. O ZIP fica maior, e em troca o projeto roda numa rede sem saída para a internet e ainda pula a espera da primeira execução. Uma pasta node_modules vazia não conta: nesse caso a instalação acontece normalmente.
No Python não há equivalente. Não adianta empacotar o ambiente Python dentro do ZIP, porque ele guarda caminhos fixos da máquina onde foi criado e não funciona em outra. Um projeto Python com requirements.txt, e todo Código Inline que importe biblioteca externa, precisa de acesso aos repositórios na primeira execução.
Padrões de segurança
Duas garantias valem para qualquer código que você escrever numa etapa de Regra Customizada, independente de qual dos três blocos:
Isolamento de processo
O script principal (Inline ou Projeto) roda num processo do sistema operacional completamente separado do runtime, e não uma sandbox dentro do mesmo processo, um processo próprio de verdade. A comunicação com o processo principal acontece só por um retrato (snapshot) das variáveis do momento em que o script começa, e pelo que bm.done() devolve ao final. Por isso o script principal não tem, e não tem como ter, acesso à sessão do navegador que a etapa está controlando: essa referência simplesmente não existe do outro lado do processo. Se você precisa desse acesso, é para isso que existe o Script de Sessão, que roda dentro do próprio processo do runtime.
Variáveis de sistema protegidas
Toda variável de sistema ({processID}, {instanceID}, {processName} e as demais, listadas em Manipulação de Variáveis) é marcada como protegida assim que o processo começa a rodar. Se o seu código, seja o script principal ou o Script de Sessão, tentar sobrescrever uma dessas chaves, a escrita é silenciosamente ignorada: não há erro, só não tem efeito nenhum. Isso vale para os três blocos igualmente, então não é possível, por acidente ou de propósito, um script alterar a identidade ou o histórico de erro do processo em andamento.
Dado sensível e o seu código
O script recebe o valor real das variáveis marcadas como Dado sensível, porque precisa dele para trabalhar. A marca protege o registro: o valor some do log, do estado guardado pelo debug e do arquivo de teste. O que o seu próprio código cria não é marcado sozinho, então registre identificadores em bm.bmLog(), nunca o dado em si. Uma credencial que você conhece antes de executar deve vir do Cofre, com bm.secret('CHAVE'). Veja Logs Customizados.
Estado entre etapas
Como cada script roda num processo separado, que nasce e morre junto com a etapa, nada que esteja vivo na memória do código sobrevive até a etapa seguinte. Isso costuma surpreender em um caso específico: o aplicativo aberto por uma etapa continua aberto, porque quem o mantém de pé é o sistema operacional, mas o objeto que o representava no código desapareceu com o processo.
A regra prática, que vale tanto para aplicativos quanto para arquivos: entre etapas só atravessa identificador, nunca objeto.
| O que a etapa produziu | O que você passa adiante |
|---|---|
| Aplicativo aberto | O PID do processo, com o título da janela como alternativa |
| Arquivo gerado | O caminho absoluto do arquivo |
| Objeto de aplicação, janela, conexão de banco, planilha aberta, sessão autenticada | Nada. Refaça na etapa seguinte a partir do identificador |
import subprocess
from pywinauto import Application

processo = subprocess.Popen(r'C:\Program Files\ERP\erp.exe')
app = Application(backend='uia').connect(process=processo.pid, timeout=60)
app.window(title_re='.*ERP.*').wait('ready', timeout=60)

bm.done('aberto', {'{erp_pid}': str(processo.pid)})from pywinauto import Application
pid = bm.get('{erp_pid}')
try:
app = Application(backend='uia').connect(process=int(pid), timeout=30)
except Exception:
app = Application(backend='uia').connect(title_re='.*ERP.*', timeout=30)
janela = app.window(title_re='.*ERP.*')
janela.set_focus()planilha.save('saida.xlsx') some antes da etapa seguinte existir. Salve sempre em caminho absoluto e devolva o caminho em bm.done(), para a próxima etapa saber onde procurar.
A mesma etapa pode ser executada mais de uma vez, seja por uma nova tentativa da Gestão de Erros, seja depois de uma parada manual que interrompeu o script no meio. Por isso, uma etapa que dirige um aplicativo deve começar normalizando a tela (fechar um diálogo pendente, voltar à tela inicial) em vez de assumir onde a execução anterior parou.
Limite de Tempo do Script
Cada etapa de Regra Customizada define por quantos segundos o seu script pode rodar antes de ser encerrado, no campo Limite de Tempo do Script, logo abaixo do código. Vale igual para Python e Node.js, no modo Inline e no modo Projeto, e o padrão é 3600 segundos (1 hora).
Ao estourar, a etapa é encerrada e conta como erro, entrando na Gestão de Erros da etapa, onde pode virar nova tentativa ou um contorno. A tabela de valores sugeridos e o raciocínio para escolher estão em Timers.
Variáveis do Fluxo
Toda etapa de Regra Customizada tem, nativamente, a seção Variáveis do Fluxo, independente de ter código em qualquer dos blocos acima. Ela cria variáveis locais, que existem só dentro do fluxo e não passam pela Matrix, e também altera variáveis que já existem (uma global, uma automática ou outra local). O valor pode ser um texto fixo, outra variável ou uma fórmula, sem escrever bm.get()/bm.done() só para montar uma mensagem ou fazer uma conta.
Como as variáveis rodam antes dos scripts, o código da mesma etapa já as lê com bm.get('{nome}'). Para o tratamento completo, com os modos de valor, os tipos, o contador e as regras, veja Manipulação de Variáveis → Locais.
Iterações de Listas
Toda etapa de Regra Customizada também tem, nativamente, uma seção Iterações de Listas, independente de ter código preenchido em qualquer um dos três blocos acima. Ela consome um item de uma variável lista a cada execução da etapa, sem precisar escrever bm.get()/bm.done() só para avançar um índice manualmente.
O seletor da seção lista as variáveis do tipo Lista do fluxo, com o selo [ ], e as variáveis que um script grava, nesta etapa ou em outra, sem o selo: elas não têm tipo declarado, e o tipo vem da execução (uma lista é percorrida item a item; um texto é cortado nas vírgulas). As do script desta etapa aparecem assim que o script é escrito, porque a iteração roda depois dele. Uma variável com tipo declarado diferente de Lista não aparece. Para uma variável de script valer como lista em todo o fluxo, declare o mesmo nome em Variáveis do Fluxo, com Tipo Lista, na mesma etapa do script: o que o script gravar nela é lido como lista.
O tratamento completo, com direção da varredura, múltiplas listas na mesma etapa e como combinar com a condição de rota que decide se o loop continua, está em Loop → Iterações de Listas.
Timer de Espera
Toda etapa de Regra Customizada tem, nativamente, a seção Timer de Espera, logo abaixo de Iterações de Listas. Ela tem um slider de segundos, de 0 a 600, que faz o processo aguardar antes de seguir para a próxima etapa. Começa sempre em 0, ou seja, sem espera, e dispensa escrever setTimeout ou time.sleep() só para uma pausa.
A espera roda no fim da etapa, depois das variáveis, dos scripts e da iteração de listas. Os scripts com pausa escrita à mão continuam valendo: o slider é a maneira visual, e o script segue sendo o caminho para esperar até uma condição. Como escolher entre os dois, o que acontece com o botão Parar e o que vai para o log está em Timers → Timer de Espera.