Use o OCR quando o dado que você precisa capturar não existe como texto na página, porque está renderizado dentro de uma imagem, um PDF ou um documento escaneado:
Notas fiscais e boletos disponibilizados como PDF ou imagem
Comprovantes e recibos escaneados (TIFF de alta resolução)
Sistemas legados que renderizam valores como imagem
Imagens embutidas direto no HTML como data URI (src="data:image/png;base64,..."), sem link separado pra baixar
Formulários e anotações preenchidos à mão (ICR). Assinaturas não, mas texto manuscrito legível, sim
Se o texto existe no HTML da página, prefira a captura normal por seletor (Mapeamento de Dados), que é mais rápida e mais precisa.
ICR (texto manuscrito) também é suportado, automaticamente
Não existe um modo separado para ativar ICR. O motor de OCR já reconhece texto manuscrito na mesma chamada usada para texto impresso. Ou seja: todo Tipo de OCR desta página já tenta ler manuscrito quando ele aparece na imagem/documento, sem nenhuma configuração extra.
Não existe uma etapa dedicada de OCR
O OCR é um recurso que se liga automaticamente a duas ações de mapeamento, Preencher e Obter Informação, e a nenhuma outra. A opção de OCR só aparece nessas duas, dentro da seção Gestão de Arquivos do mapeamento (veja Mapeamento de Dados).
Configuração no mapeamento
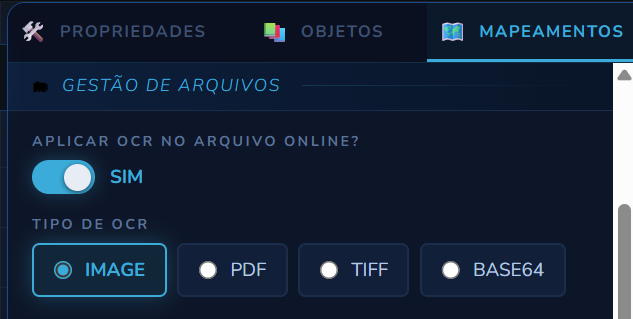
O OCR é ativado por linha de mapeamento, na seção Gestão de Arquivos:
A seção Gestão de Arquivos de um mapeamento Obter Informação, com o Tipo de OCR mostrando as quatro opções desse fluxo: IMAGE, PDF, TIFF e BASE64.
Esse mapeamento dispara download?booleano
Só existe em Preencher, e só é capturado com Tipo de Evento Clicar: é o clique que dispara o download no navegador. Diz que a ação daquele mapeamento baixa um arquivo (o clique num botão "Baixar PDF", por exemplo) e traz o arquivo baixado como dado do processo. É dali que o OCR lê, quando ativado: não importa se o arquivo vai ou não sobreviver à execução (veja a seguir), o OCR sempre roda antes de qualquer limpeza.
Ao ligar, aparece Manter o download após a execução?. Desligada (padrão), o arquivo fica numa pasta interna apagada ao final. Ligada, é obrigatório informar a Pasta de Destino do Download, um caminho real na máquina onde o agente roda.
Se o download falhar (ou nunca acontecer), a etapa é interrompida com uma exceção formal antes de chegar ao OCR, em vez de ler uma pasta vazia. Essa exceção é tratada como qualquer outro erro de etapa pela Gestão de Erros e Exceções. Veja como o agente detecta a conclusão do download, o teto de espera e as variáveis geradas em Download.
Aplicar OCR no arquivo de download? / no arquivo online?booleano
Ativa o reconhecimento óptico de caracteres para esta linha de mapeamento. O texto reconhecido é armazenado na variável do processo configurada na linha, com o sufixo .OCR.
Em Preencher, só aparece com Esse mapeamento dispara download? ligado: o OCR lê o arquivo que o download acabou de trazer, então sem download não há o que ler.
O rótulo muda conforme a etapa, porque a origem do arquivo é outra: em Preencher o OCR lê o arquivo que acabou de ser baixado para a pasta de destino; em Obter Informação ele lê o endereço que o próprio mapeamento capturou, buscando o arquivo online.
Tipo de OCRseleção
Informa ao motor de OCR qual o formato do arquivo de origem. Veja a tabela abaixo.
O texto lido de um documento costuma ser dado pessoal
Um CPF, um contrato ou uma nota fiscal viram texto e passam a existir como variável. Em um mapeamento de Obter Informação, ligue Dado sensível? na linha (veja Mapeamento em Obter Informação): a marca vale também para o texto reconhecido por OCR dessa linha, que deixa de aparecer nos logs, no estado guardado do debug e no arquivo de teste de scripts. As etapas seguintes continuam recebendo o texto. Veja Dados Sensíveis.
Tipos de OCR
O motor por trás do OCR é o Google Cloud Vision, acionado pelo runtime através do Router da plataforma (o runtime nunca guarda a credencial do serviço). O Tipo de OCR escolhido decide como o arquivo chega até o Vision, e as opções mudam conforme a ação, porque nem todo tipo tem como funcionar nos dois fluxos:
Tipo
Disponível em
Formato de origem
Uso típico
PDF
Preencher e Obter Informação
Documento PDF
Notas fiscais e contratos. Extrai o texto de todas as páginas
TIFF
Preencher e Obter Informação
Imagem TIFF de alta resolução
Documentos escaneados em scanners corporativos
IMAGE
Obter Informação
JPEG, PNG, WebP
Prints, imagens de valores, fotos de documentos
BASE64
Obter Informação
Imagem embutida no HTML como data URI
Sistemas que embutem a imagem direto no atributo, sem link separado
Por trás dos quatro tipos existem três modos do VisionPDF e TIFF usam o mesmo modo de documento, mudando só o mimeType declarado (application/pdf ou image/tiff): o motor lê o arquivo em bytes, local ou remoto, e envia o conteúdo. IMAGE usa o modo de imagem do Vision passando uma URL, que o próprio Vision busca. BASE64 usa esse mesmo modo de imagem, mas por conteúdo: o motor decodifica o data URI localmente e manda os bytes direto, sem passar URL nenhuma pro Vision.
Por que cada tipo só existe onde existe
Em Preencher, só PDF e TIFF aparecem, porque são os únicos formatos que um clique realmente consegue baixar no navegador: PDF quando o site força o download em vez de abrir o visualizador embutido, TIFF porque o navegador nunca sabe renderizar esse formato e sempre baixa. Uma imagem comum (JPEG, PNG, WebP) nunca dispara download, o navegador sempre abre ela direto na aba, então nunca existe um arquivo assim pra ler depois, por isso IMAGE e BASE64 não aparecem nesse fluxo. Em Obter Informação, o OCR não depende de download nenhum, lê o endereço capturado direto: IMAGE funciona porque normalmente esse endereço é uma URL de verdade (src/href), e BASE64 cobre o caso em que a imagem vem embutida no próprio atributo, sem link separado nenhum.
Fluxos típicos
A origem do arquivo que o OCR lê muda conforme a ação:
Via Preencher, com download
A etapa navega até o documento e clica no botão que dispara o download (ex.: "Baixar"). O mapeamento desse clique precisa ter Tipo de Evento Clicar: é o único evento que captura download.
No mesmo mapeamento, ative Esse mapeamento dispara download? para que o arquivo baixado seja trazido como dado do processo. Se precisar que o arquivo sobreviva à execução, ative também Manter o download após a execução? e informe a Pasta de Destino do Download. Sem isso, ele fica só numa pasta interna, apagada ao final, o que já basta pro OCR ler.
Ative Aplicar OCR no arquivo de download? e selecione o Tipo de OCR conforme o formato do arquivo, PDF ou TIFF (são os únicos disponíveis nesse fluxo, veja o aviso acima). O OCR lê o arquivo já baixado localmente pelo runtime.
O texto reconhecido fica em {nome_da_variavel.OCR}, ou seja, o Nome dado à linha de mapeamento, com o sufixo .OCR. Use nas etapas seguintes, ou refine com Regra Customizada (regex, parsing).
Via Obter Informação, sem download
Mapeie o atributo que contém a imagem ou o documento. Na maioria dos sites é um endereço de verdade, normalmente src (imagem) ou href (link para PDF): use IMAGE, PDF ou TIFF conforme o formato, e o runtime busca o arquivo direto dessa URL antes de rodar o OCR.
Em alguns sistemas o atributo não é um endereço, é a imagem inteira embutida ali, um data URI (data:image/png;base64,AAAA...). Nesse caso use BASE64: o runtime decodifica o conteúdo localmente, sem tentar buscar um endereço que não existe.
Ative Aplicar OCR no arquivo online? e o Tipo de OCR correspondente.
O resultado vai para {nome_da_variavel.OCR}, da mesma forma.
Dicas de precisão
Informe o tipo correto. Cada tipo usa um modo diferente do Vision (veja o aviso acima). Escolher o tipo errado para o formato real do arquivo, por exemplo TIFF sobre um PDF, degrada muito o reconhecimento ou não funciona.
Resolução importa. Documentos escaneados abaixo de 300 DPI reduzem a taxa de acerto; peça escaneamentos melhores quando possível.
Pós-processe com código. O OCR devolve o texto bruto. Normalize com Regra Customizada (ex.: regex para extrair o CNPJ ou o valor total do texto reconhecido).
Valide com Decisão. Após o OCR, use uma etapa de Decisão para verificar se o dado esperado foi encontrado (ex.: {texto_pdf.OCR}.includes('CNPJ')) antes de prosseguir.